跳至主要内容

幫家人整理舊資料

· 閱讀時間約 3 分鐘

家裡的舊電腦、舊硬碟備份堆了好幾年,照片、文件散在一堆「新增資料夾」裡,這次請 AI 一起幫忙整理,順手記一下做法。

1. 整理時的幾個小發現​

  • 刪之前先比對:以為「整理版」已經夠了,用 hash 比對後,還是從原始資料救回十幾張照片,包括一張漏掉的畢業合照。找重複檔時先比大小,大小一樣才算 hash,快很多
  • Google 相簿匯出的 .json 別直接刪:看起來很多餘,但有兩成照片的拍攝時間只存在 json 裡。可以先用 exiftool 把時間寫回照片的 EXIF,之後 json 就能放心刪了
  • 要不要打包成 ZIP:照片、影片本身已經壓縮過,打包也不會變小,但幾千個小檔案包成一個,搬移、備份會快很多。這次考量直接看縮圖比較方便,最後選擇不打包。

2. 用本地模型找出「有貓的照片」​

想從幾千張照片裡把家裡貓咪的照片挑出來。這些都是家人的生活照,所以直接在自己電腦上跑辨識模型,照片完全不用離開電腦。

順便一提,費用上也差很多:

做法大概的 token
AI 一張一張看(約 4,500 張)500 萬以上
縮圖拼成 5×5 合圖再給 AI 看30 萬左右
在自己電腦上跑辨識模型幾乎 0

做法是本地跑 YOLO:

  • 用 uv 開一個 Python 3.12 的環境(系統的 3.14 還沒有 torch 可以裝)
  • 裝 CPU 版的 torch + ultralytics,模型用最小的 yolo11n
  • 筆電沒有獨顯(i7-1260P),4,837 張大概跑了 12 分鐘
uv venv --python 3.12 .venv
uv pip install --python .venv\Scripts\python.exe torch torchvision --index-url https://download.pytorch.org/whl/cpu
uv pip install --python .venv\Scripts\python.exe ultralytics

模型會給每張照片一個「有貓的信心分數」,接下來分三段處理:

  • 高分:直接收,隨機抽 25 張檢查,全部都是貓
  • 中間:模型沒把握的 61 張拼成合圖再確認,其中 54 張真的有貓
  • 誤判:貓的擺飾、投影片、還有瀑布照

這次中間那批是請小助理看合圖確認的,不過回頭想想,需要確認的也就幾十張,自己看一下就好。

本地模型粗篩 + 自己複查,就已經很夠用了,照片也不用上傳到任何地方。

找到的照片另外複製一份到「貓咪」資料夾,原本的活動資料夾不動,這樣每次活動的照片還是完整的。

用完記得把環境刪掉,torch 加上 uv 的快取差不多佔了 2GB。

3. 舊文件變成一個小網站​

長輩有一批很久以前寫的 Word 文件,想做成手機也能方便翻的樣子,有點像個人的小小博物館:

  • 用 Word 的 COM 介面批次把 .doc 轉成純文字
  • 統一簡繁、去掉空白後比對,把重疊的部分拿掉
  • 做成純靜態網頁,雙擊 index.html 就能開,不用架伺服器
  • 搜尋簡繁通用(OpenCC 做對照表),長段落自動分段,半形標點轉成全形

小結​

這次的收穫是「本地模型 + 自己複查」這個組合:家人的照片不用交給雲端,準確度也夠,以後要從一堆照片裡找東西都可以這樣做。
FFmpeg 要 full 版,壓 AV1 才快

· 閱讀時間約 1 分鐘

要把影片轉成 AV1,結果一看,手上的 FFmpeg 能用的 AV1 編碼器只有 libaom-av1,這顆很慢。

原因是之前裝的不是 full 版,裡面沒有 libsvtav1(SVT-AV1)。換成 full 版就有了:

winget install Gyan.FFmpeg

(winget 的 Gyan.FFmpeg 就是 full 版)

裝完要注意 PATH,如果舊版還在系統 PATH 裡,打 ffmpeg 會先抓到舊的,記得把舊的移掉。

確認有沒有 SVT-AV1:

ffmpeg -hide_banner -encoders | findstr av1

有看到 libsvtav1 就對了。

實測 Ryzen 5 3600,1080p、-preset 5 -crf 26,30 秒的影片大約 18 秒壓完。

ffmpeg -i input.mp4 -c:v libsvtav1 -preset 5 -crf 26 -pix_fmt yuv420p -c:a copy output.mp4

筆記​

AI 小助理:先做一次、留下步驟

· 閱讀時間約 2 分鐘

今天又請 AI 小助理做了兩個東東。

1. EPUB 合併​

把好幾冊 EPUB 合成一本,照某個「合併版」的格式,只留第一冊封面跟每章的章首插畫,其他圖版拿掉,章首插畫再等比例縮到寬高都不超過 600px。

這樣閱讀器就不會卡在讀圖片,讀很久最後還失敗。

做完之後,順便請它把整個流程寫成一份備註,內容包括:

  • 哪些圖要留、哪些要刪,每種圖片怎麼縮、怎麼轉
  • 工具怎麼執行,有哪些注意事項
  • 完成後要驗證什麼(章節順序、目錄連結等)
  • 換成別本書時,哪些地方要先重新確認

以後有其他書要處理,直接叫 AI 先看這份備註,再照同樣的方式跑一次就好。

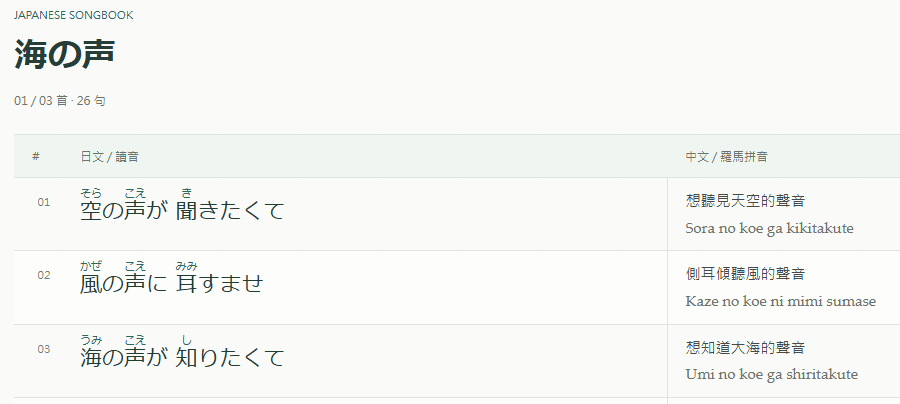
2. 日文歌詞頁​

第二個是把日文歌詞整理成一個簡單的頁面:

  • 左邊是原文歌詞,漢字上方會標平假名
  • 右邊是羅馬拼音跟中文翻譯

2026-10-28-lyrics.png

接著照資料格式寫成一份 skill/README.md,以後只要貼上日文歌詞,就會自動補好讀音、拼音跟翻譯,再加進歌曲清單裡。

讀音交給 AI 判斷,不太會出現那種機翻把漢字讀音標錯的狀況,遇到不確定的特殊唱法也會先標出來,不會自己亂改。

總結​

這兩件事的重點都一樣:先做一次、留下步驟。

第一次跟 AI 來回調整到滿意,再請它把做法寫成文件或 Skill,之後要擴充只要丟新資料進去就好,不用每次重新解釋一遍。

Reddit 開始限制 API 呼叫了

· 閱讀時間約 1 分鐘

MSOutlookit(不方便明說是幹嘛的),前陣子都還能用,最近打開來卻只有一片空白。

查了一下,直接從前端瀏覽器打 Reddit 的 API,現在全部回 403。

只好請小助理幫忙改成用本機後端呼叫的版本,把自己的 Cookie 帶進去,這樣打 API 就會通了。

(↑用 Cloudflare Worker 之類的方法大概也行)

順便看了一下 reddit_session 的期限,大概半年,貼一次可以用很久。

而純靜態的作法大概是沒救了。

另外 api.js 會自動判斷:有後端就走後端,沒有後端(例如丟到靜態網站上)就退回原版的 JSONP,等哪天 Reddit 又放寬了,靜態版也能自己復活,雖然不太可能。

guestbook 阻擋垃圾訊息

· 閱讀時間約 1 分鐘

自從上次我自己搞自己,把留言簿改成支援「HTML Form/No-JS」形式之後,就開始陸陸續續收到一些垃圾訊息了。

因為收到的清一色都是包含 <a> 標籤的連結,所以特別用後端(Google Apps Script)阻擋掉了。

然後順便改善了一下 JS 版按鈕的體驗,現在「送出中」做得更明顯,成功送出後也有 CD 時間。

其實 AI 一直叫我做蜜罐欄位(honeypot),就是做一個隱藏的輸入框,一般人用 CSS 隱藏起來看不到,只有機器人才會填。

但我覺得應該還不需要搞得那麼麻煩,暫時先這樣測試看看就好。

不然直接把 Form 版拿掉就好了,反正又沒人在用。

我們的未來

· 閱讀時間約 1 分鐘

「沒想到會被核彈炸」

這是昨天聽歌時,腦中冒出的潛台詞。

《僕たちの将来》 中島みゆき​

故事前半段在講一對情侶互有不滿,卻又試著打圓場,談著一段看似沒有出路的關係。

明知早已進退兩難,卻依然若無其事地刻意迴避。

「我們大概沒問題吧?應該會越來越好吧?」

無論是這段關係、抑或是這個世界。

最後一段歌詞:

在那片藍得過於濃烈的電視畫面裡,煞有其事地談論著炎熱國家的戰爭。

比起遙遠海洋另一端的事情,我更不滿眼前這塊怎麼樣也切不動的牛排。

我們的未來,就在令人目眩的閃光之中。
我們的未來...
我們的未來...
我們的未來...會越來越好嗎?


更妙的是,在最後核爆的瞬間1,卻突然切入下一首歌。

「初次見面,明天」,讓人有種死而後生的感覺。


唉,這種誰也說不準的微妙對照,在不熟悉日文的前提下更加難以意會。

畢竟,整段套用到台海關係,大概也不會有問題。

完蛋,越來越想學日文了。(← 我 N6)

Footnotes​

  1. 《僕たちの将来》結尾處有著非常不尋常的聲音與倒數。 ↩

馬會游泳

· 閱讀時間約 1 分鐘

郭靖放開白馬韁繩,說道:「你沒用,自己去吧。」在紅馬臀上一拍,二人一馬,一齊躍入大江。小紅馬一聲長嘶,領先游去。郭靖與黃蓉並肩齊進。游到江心,那紅馬已遙遙在前。

「馬會游泳!?」 ← 這個人甚至可能沒看過馬。

我同學:「哺乳類動物大部分都會游泳」,然後傳了一堆動物游泳的影片給我看。

結論是:大概只有我和黑猩猩不會游泳。


Bonus 補一個很靠腰的斷章:

等到天黑,朱聰與全金發伏在郭靖母子的蒙古包外,過了小半個時辰,只聽郭靖說道:「媽,我去啦!」

FreshRSS 抓取受 Cloudflare 保護的 Feed

· 閱讀時間約 2 分鐘

問題​

大概半年前,我發現使用 FreshRSS 追蹤的一些 RSS/Atom Feed 會被 Cloudflare 驗證給擋下。

當時的解法是用 Cloudflare Worker 當跳板去抓,雖然偶爾還是會被擋,但是在大多數的情況下是 OK 的。

BUT!最近幾天整個大失效,不論是直連還是跳板都被擋,導致漏掉了許多訂閱的文章。

解決​

今天照關鍵字查了一下,發現 Ivon 的這篇「介紹 FreshRSS 的文章」裡面有解法!

馬上安裝起來,成功解決!

原理是呼叫 Flaresolverr 來開一個「Selenium + undetected-chromedriver」去抓那些被擋掉的 Feed。

提示

部署方式可以參考「這篇筆記」。

額外討論​

缺點是這個擴充套件的 API 可以直接被存取,如果你的 FreshRSS 是直接暴露在 Public 的,就有機會被有心人士濫用,拿去當成 Proxy 跳板。(不曉得機率有多大...)

所以,透過 Tailscale 之類的服務去存取 FreshRSS 可能還是比較安全一點。

或者,你可能需要特別針對擴充套件的 API 設定存取限制。(也太麻煩了吧)

不過,既然已經知道使用 Flaresolverr 可以順利抓到 Feed,那你也完全可以自己寫(AI 寫)一個迷你服務去呼叫 Flaresolverr 抓 Feed,這樣就沒問題啦。

所以我最後怎麼做?當然是什麼也不做,等真的遇到問題再說囉(???)

Barcode 圖片出現抖動/鋸齒

· 閱讀時間約 1 分鐘

今天遇到 Barcode 掃描不太到的問題。

在電腦上,不論是用「PDF 軟體」還是「內建 PDF Viewer 的瀏覽器」看都沒問題。

但實際上印出來就會發現有「抖動/鋸齒/毛邊」的狀況,變得很難掃描。

因此推測可能是電腦上的軟體都會自動做「抗鋸齒」或「平滑顯示」的處理。

所以,當你要縮放 Barcode 圖片時(非向量圖),盡量要做「Integer Scaling(整數縮放)」才比較不會有問題。

2026-09-18-barcode.png

Oral-B 電動牙刷換電池

· 閱讀時間約 1 分鐘

說到自己換電池,想到昨天才在網路上學到如何幫 Oral-B 的電動牙刷換電池。

整個過程非常簡單:把牙刷插上充電座之後轉 90 度扭開,接著把本體推出來,再換上電池就可以了。

每個型號的做法可能不太一樣,但是都非常容易更換,超讚。